请先完成链路的链接与闭环然后再继续阅读。
在第一阶段形成的闭环中主要是针对视频生成,在生成完视频之后还需要配音字幕等角色,我们使用tts进行配音,即文字转语言模型。这里有两种思路,如果对音色要求不高可以找ai腔的音频,这种音频满大街都是,我们主要讲解另外一种思路。
这里需要用到F5-TTS和ffmpeg,自行下载即可。
F5-TTS是一种快速克隆声音、生成几段配音的配音方案,如果需要更精确克隆声音可以使用开源软件GPT-SoVITS,不过他需要GPU进行训练。
我们以F5-TTS为例,需要准备一段角色原声音频和对应的参考文本,然后完成第一次配音测试,可以看到,他直接只是用F5-TTS和ffmpeg完成了后续步骤的组装。
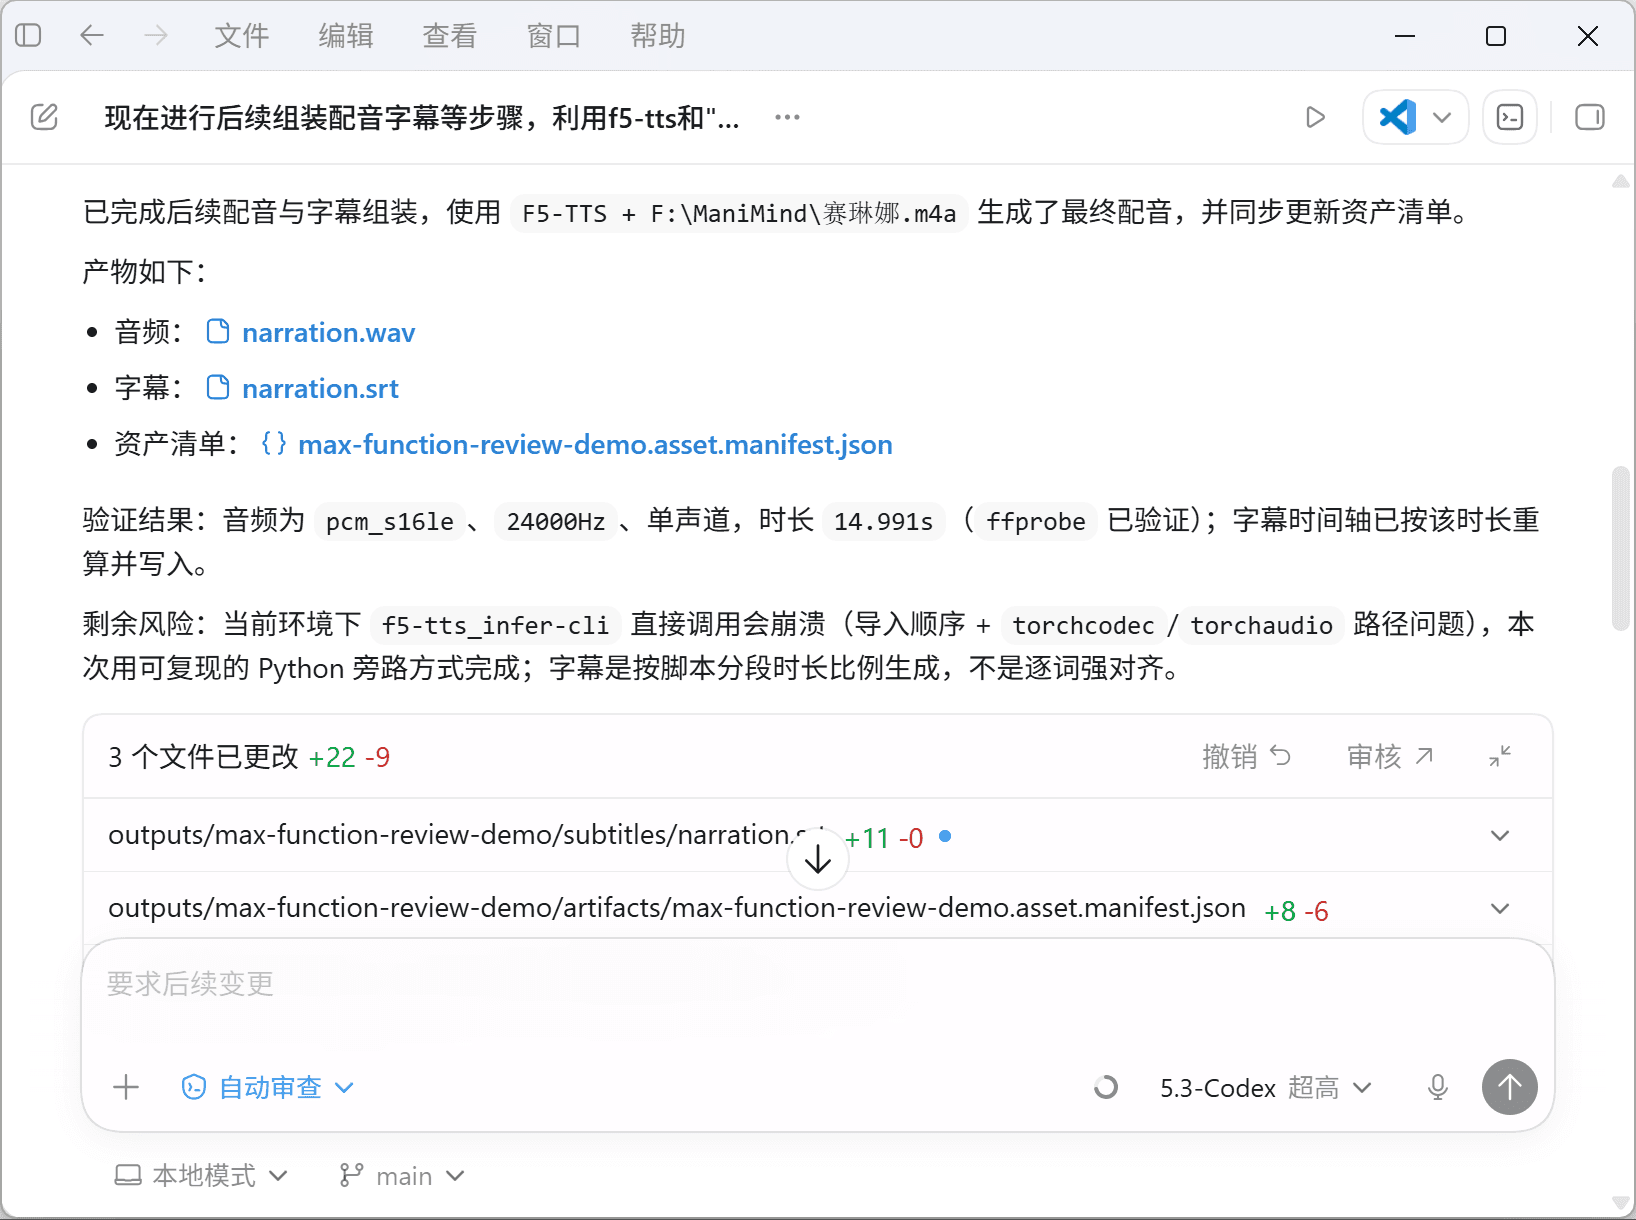
这里有一个可以优化的点,每次配音的时候可以让模型权重缓存、参考音频固定,这样后续配音时间就会缩短。
Tip
值得注意的是,正常的初次tts可能相对耗时,这时候大模型可能会写脚本利用参考音频的前12秒进行训练,你至少需要保证前12秒存在人声,清晰无立体音,要不然训练出来的音色可能与原音完全不一样。
完成之后将后处理阶段并入主链路。